엔비디아 RTX 30·40 그래픽카드, 인공지능 성능이 정말 두 배 빨라질까?
그래픽카드를 바꾸지 않고 숨겨진 성능을 끌어낼 수 있다는 소식이 나오면 관심이 갈 수밖에 없습니다. 특히 요즘처럼 그래픽카드와 메모리 가격이 부담스럽게 느껴질 때는 더 그렇습니다.
저는 2년 전 결혼하면서 컴퓨존에서 RTX 4070 Ti가 들어간 컴퓨터를 새로 구입했습니다. 지금도 쓰는 그래픽카드라서 5070이나 5080으로 업그레이드하고 싶은 마음은 있지만, 가격을 보면 선뜻 손이 가지 않더군요.
그러다 RTX 30·40 시리즈의 텐서 코어 연산 속도를 개선하는 실험이 공개됐다는 소식을 봤습니다. 4090에서는 실제로 특정 연산 처리량이 두 배 가까이 측정됐고, 제가 사용하는 4070 Ti에도 실험 기록이 있습니다. 다만 이 숫자를 게임 프레임이나 모든 인공지능 작업에 그대로 적용해서는 안 됩니다.
먼저 알아둘 점: 이번 기술은 엔비디아가 배포한 공식 드라이버 최적화가 아니라 개발자 커뮤니티의 비공식 GPU 언락 실험입니다. 실험 성공과 일반 사용자 PC의 안전한 적용은 별개의 문제입니다.
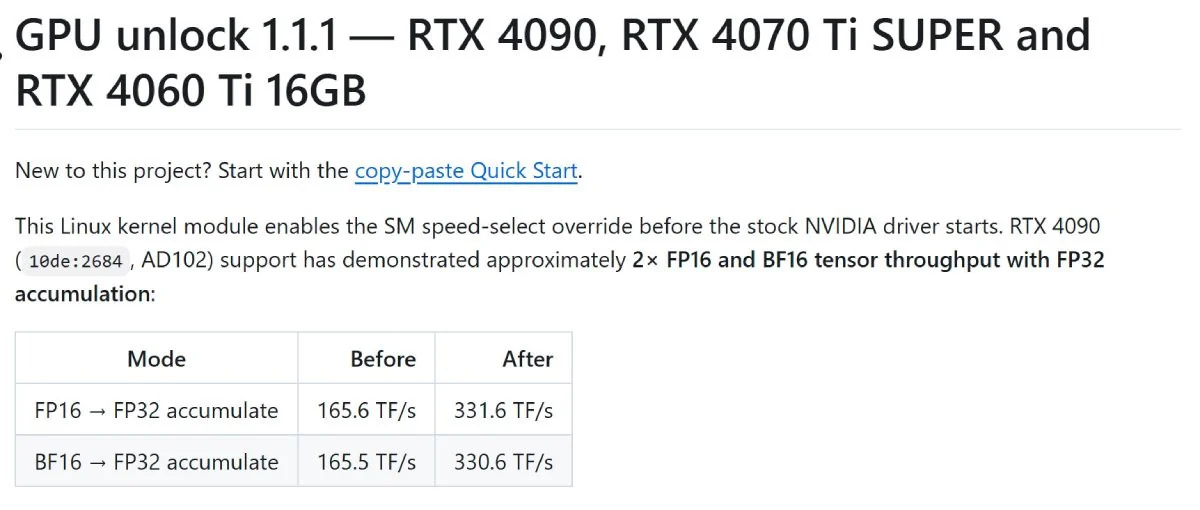
RTX 30 시리즈의 FP16·BF16 행렬 연산 제한을 다룬 프로젝트 관련 이미지입니다.
RTX 그래픽카드 언락 기술의 원리 – 무엇을 바꾸는 걸까?
텐서 코어, FP16·BF16, FP32 누적의 차이
RTX 그래픽카드에는 게임 화면을 처리하는 셰이더 연산부 외에, 인공지능과 행렬 계산을 돕는 텐서 코어(Tensor Core)가 있습니다.
여기서 입력값을 16비트 부동소수점(FP16·BF16)으로 처리하면서 계산 결과를 32비트(FP32)로 누적하는 방식이 사용됩니다.
이번 실험은 이런 FP16/BF16 입력 → FP32 누적 경로의 명령 실행 속도를 선택하는 내부 설정을 바꾸는 접근입니다. GPU 코어 수나 메모리 용량이 늘어나는 것이 아니라 특정 텐서 명령을 발행하는 속도가 달라집니다.
같은 그래픽카드에서 바뀌는 부분
개발자 설명에 따르면 엔비디아 드라이버가 GPU를 초기화하기 전에 리눅스 커널 모듈로 속도 선택 상태를 변경합니다.
이후 기존 엔비디아 드라이버가 로드되는 방식입니다. 모든 소비자용 카드가 전문가용 카드와 동일한 칩을 쓴다는 뜻은 아니며, 시장 구분을 위해 의도적으로 제한했는지까지 이 실험만으로 확정할 수는 없습니다.
RTX 4090 실제 성능 비교 – 165.6에서 331.6 테라플롭스로
| 검증 항목 | 기본 상태 | 언락 후 | 해석 |
|---|---|---|---|
| RTX 4090 · FP16 입력/FP32 누적 | 165.6 TFLOPS | 331.6 TFLOPS | 특정 텐서 명령 약 2배 |
| RTX 4090 · BF16 입력/FP32 누적 | 165.5 TFLOPS | 330.6 TFLOPS | 특정 텐서 명령 약 2배 |
| RTX 4090 · INT8 정수 연산 | 661.6 TOPS | 약 661.4 TOPS | 거의 변화 없음 |
| RTX 4090 · 일반 FP32 셰이더 연산 | 79.1 TFLOPS | 약 79.0 TFLOPS | 거의 변화 없음 |
출처: gpu-unlock-ada 개발자 실험 보고서. 수치는 특정 벤치마크의 연산 처리량이며 게임 FPS나 전체 인공지능 작업 성능이 아닙니다.
특히 주목할 부분은 INT8·일반 FP32 연산은 거의 그대로라는 점입니다.
로컬 언어 모델 가운데 양자화된 연산을 주로 사용하는 구성에서는 성능이 별로 변하지 않을 수 있습니다.
별도의 RTX 4090 실험에서도 실제 행렬곱(cuBLAS)의 속도는 작업 크기에 따라 FP16 약 12~34%, BF16 약 16~20% 향상하거나 사실상 차이가 없었습니다. 따라서 “인공지능 게임·영상 편집 속도 모두 2배”라는 식의 표현은 맞지 않습니다.

RTX 40 시리즈의 텐서 연산 속도 향상은 연산 종류에 따라 다르게 나타납니다.
내가 쓰는 RTX 4070 Ti도 적용될까? 4070 Ti SUPER와 다른 점
RTX 4070 Ti와 4070 Ti SUPER는 이름이 비슷하지만 같은 그래픽카드가 아닙니다.
제가 사용하는 일반 RTX 4070 Ti는 12GB·AD104이고, RTX 4070 Ti SUPER는 일반적으로 16GB·AD103을 사용합니다.
일부 기판·GPU 변형도 있어서 모델 이름만 보고 무리하게 동일한 설정을 적용하면 안 됩니다.
| 제품 | 그래픽 칩·메모리 | 언락 기록 | 일반 사용자 적용 판단 |
|---|---|---|---|
| RTX 3090 Ti | 암페어 GA102 · 24GB | BF16 행렬곱 약 +80% 사례 | 리눅스 개발자 프로젝트, 환경 검증 필요 |
| RTX 4090 | 에이다 AD102 · 24GB | FP16/FP32 텐서 명령 약 2배 | 가장 많은 검증 기록이 있는 편이나 비공식 |
| RTX 4070 Ti | 에이다 AD104 · 12GB | 리눅스 한 장의 VFIO 실험에서 텐서 명령 약 2배 | 실험 단계, 실사용 윈도우 PC 직접 적용 비권장 |
| RTX 4070 Ti SUPER | 에이다 AD103 · 16GB (주요 구성) | FP16/FP32 약 95.0 → 189.9 TFLOPS | 일부 보드에서 실험, 다른 칩 변형 주의 |
| RTX 5070·5080 | 블랙웰 RTX 50 시리즈 | 현재 프로젝트의 대상 아님 | 40 시리즈 결과를 적용 불가 |
RTX 4070 Ti 12GB·SUPER 16GB는 엔비디아 공식 사양, 각 언락 기록은 프로젝트의 공개 실험을 기준으로 작성했습니다. 카드 제조사·칩 변형에 따라 호환성이 달라집니다.
4070 Ti 실제 실험은 얼마나 빨라졌을까?
2026년 10월 24일 공개된 RTX 4070 Ti(PCI 장치 ID 10de:2782) 실험은 리눅스 가상 머신에 물리 그래픽카드를 직접 연결한 VFIO 환경에서 진행됐습니다.
테스트된 ASUS 기판 한 장에서 FP16·BF16·TF32의 FP32 누적 텐서 명령 처리량이 약 두 배로 측정됐고, 대형 cuBLAS 행렬곱도 약 93~94% 향상됐습니다.
| RTX 4070 Ti 연구 측정 | 일반 상태 | 언락 후 | 증가율 |
|---|---|---|---|
| FP16 → FP32 텐서 명령 | 84.8 TFLOPS | 169.4 TFLOPS | 약 2.00배 |
| BF16 → FP32 텐서 명령 | 84.7 TFLOPS | 168.9 TFLOPS | 약 1.99배 |
| TF32 텐서 명령 | 42.4 TFLOPS | 84.0 TFLOPS | 약 1.98배 |
| 일반 FP32 연산 | 40.1 TFLOPS | 40.2 TFLOPS | 거의 동일 |
위 값은 RTX 4070 Ti AD104 연구용 장비 한 대의 공개 실험값입니다. 제 컴퓨터에서 측정한 결과가 아닙니다.
이렇게만 보면 기존 4070 Ti를 더 쓸 만해지는 것처럼 보입니다.
하지만 윈도우에서 바로 실행할 수 있는 안정화된 설치 프로그램이 아니며, 다른 제조사 그래픽카드에서 동일한 결과가 보장되지 않습니다.
윈도우 11에서도 RTX 4070 Ti 언락이 가능한가?
별도로 공개된 윈도우 UEFI 시험에서는 MSI RTX 4070 Ti·특정 메인보드 조합에서 행렬곱이 FP16 기준 약 80.1%, BF16 기준 약 76.4% 향상된 기록이 있습니다.
하지만 그 PC 전용으로 맞춘 수동 부팅 실험이며 일반 사용자에게 배포하는 범용 실행 파일이나 원클릭 설치 프로그램은 아닙니다.
따라서 인터넷에서 “4070 Ti 성능 2배.exe” 같은 파일을 받는 것은 피하는 편이 좋습니다. 이 기술의 정식 엔비디아 배포 프로그램은 확인되지 않았습니다.
GPU 언락 프로그램 다운로드 – 실제 공개된 깃허브 주소
소스코드를 검토하거나 연구 내용을 확인하고 싶다면 아래 공식 개발자 저장소를 이용하면 됩니다.
원문 기사에 등장하는 비공식 재배포 파일보다 개발 기록과 실험 조건을 확인하기 쉽습니다.
| 구분 | 다운로드·자료 | 주요 대상 |
|---|---|---|
| RTX 40 시리즈 개발 프로젝트 | gpu-unlock-ada 깃허브 | RTX 4090, RTX 4070 Ti 등 실험 지원 |
| RTX 4070 Ti 실험 보고서 | AD104 실측 기록 | 지원 기판·드라이버·장치 ID 확인 |
| RTX 30 시리즈 프로젝트 | Zagitta/gpu-unlock | 암페어 기반 제품의 리눅스 프로젝트 |
| 측정 결과 비교 | 원본 기준 벤치마크 정리 | 모델별 전후 수치·효과 없는 항목 |
주의: 이 프로젝트는 운영체제가 시작되기 전 그래픽카드 초기화 과정에 개입합니다. 검증되지 않은 펌웨어·ROM 바이너리를 받거나 다른 그래픽카드용 장치 ID를 억지로 지정하면 부팅 불가, 데이터 손상, 화면 출력 오류 등이 발생할 수 있습니다. 컴퓨터를 업무에 사용한다면 메인 시스템에서 실험하지 않는 것을 권합니다.
실험용 설치 및 설정방법 – 윈도우와 리눅스 구분
1. 현재 그래픽카드와 드라이버를 먼저 확인
윈도우 11에서는 작업 관리자 → 성능 → GPU 또는 장치 관리자 → 디스플레이 어댑터에서 모델을 확인할 수 있습니다.
엔비디아 드라이버가 설치되어 있다면 터미널이나 PowerShell에서 다음 명령으로 제품과 드라이버·메모리를 조회할 수 있습니다.
nvidia-smi --query-gpu=name,driver_version,memory.total,pci.bus_id --format=csv이 명령은 조회만 하는 안전한 방법으로, 그래픽카드 성능이나 펌웨어를 바꾸지 않습니다. RTX 4070 Ti 일반 모델인지 SUPER 모델인지부터 구분하고, 정확한 장치 ID는 리눅스의 PCI 목록이나 하드웨어 식별 정보로 재확인합니다.
2. 리눅스 사용자라면 프로젝트 설치 요구사항 확인
개발자의 공개 코드는 리눅스 커널 모듈 형태입니다.
커널 헤더와 DKMS 빌드 환경이 필요하고, 부팅 초기 단계(initramfs)에 모듈이 포함되어야 합니다.
실제 패키지를 설치하는 예시는 다음과 같지만, 지원 GPU와 복구 가능한 부팅 환경을 확보하지 않은 상태에서 실행하지 마세요.
git clone https://github.com/JustAResearcher/gpu-unlock-ada.git
cd gpu-unlock-ada
make install
명령 실행 후에도 자동으로 모든 GPU의 제한이 해제되는 것은 아닙니다.
커널 부팅 옵션에 실제 PCI 주소와 모델별 실험 플래그가 필요합니다. 특히 RTX 4070 Ti에는 gpu_unlock.ad104_experimental=1이 요구되며 다른 제품 주소를 복사해 넣으면 안 됩니다.
3. RTX 4070 Ti 실험 플래그는 일반적인 최적화 옵션이 아니다
개발자가 공개한 실험 환경에서는 다음과 같은 형식이 사용됐습니다.
PCI 주소는 시스템마다 다르며, 아래 값은 테스트 환경의 예시이지 내 PC에 입력할 고정값이 아닙니다.
gpu_unlock.targets=0000:00:10.0 gpu_unlock.ad104_experimental=1실험자는 원래 드라이버로 돌아갈 수 있는 부팅 항목을 따로 보관해야 합니다.
처음 시도할 때는 전원을 완전히 끄고 다시 켜는 방식으로 검증했고, 일반적인 재시작이나 절전 복귀에서 계속 같은 결과가 나오는지는 카드별로 다릅니다.
4. 설치 이후 확인 방법과 원상복구
지원되는 실험 환경에서는 부팅 후 커널 로그에 표시된 gpu_unlock 상태를 확인하고, 엔비디아 드라이버가 정상 로드됐는지, 그래픽카드가 정상 인식되는지, 동일 조건에서 측정값이 달라지는지 순서대로 점검합니다.
journalctl -k -b | grep gpu_unlock
nvidia-smi
원상복구할 때는 부팅 옵션의 gpu_unlock.targets= 및 실험 플래그를 제거하고 프로젝트가 설치한 모듈·부팅 이미지를 개발 문서에 따라 복원합니다. 복구용 부팅 항목 없이 메인 PC에 바로 적용하는 것은 권하지 않습니다.
게임·영상편집·로컬 인공지능에서 체감 차이는?
| 사용 목적 | 언락 성능 기대 | 그 이유 |
|---|---|---|
| 게임·DLSS·프레임 생성 | 직접적인 FPS 두 배 근거 없음 | 이번 실험이 바꾸는 연산 경로와 게임 병목이 다름 |
| 일반 3D CAD 화면 작업 | 큰 차이를 예상하기 어려움 | 뷰포트는 렌더러·드라이버·메모리·CPU 등의 영향이 큼 |
| 일부 AI 학습·행렬곱 | 실험 조건에서 큰 차이 가능 | FP16/BF16 입력·FP32 누적 텐서 명령 사용 시 |
| 로컬 언어 모델 프롬프트 처리 | 모델·추론 엔진에 따라 일부 이득 | 연산 비중이 클 때 유리할 수 있음 |
| 로컬 언어 모델 토큰 출력 | 차이가 작을 수 있음 | 메모리 대역폭·VRAM 병목 및 양자화 방식 영향 |
| 동영상 인코딩·편집 전체 | 정량적 향상 근거 없음 | 인코더·디코더·효과 처리에서 병목이 각각 다름 |
저처럼 게임도 하고 디자인·영상 관련 작업도 하는 경우라면 이 언락 하나만 보고 큰 차이를 기대하기보다 현재 어떤 작업에서 부족한지부터 파악하는 게 맞겠습니다. AI 모델이 12GB 메모리를 초과해 실행조차 되지 않는 상황이라면 텐서 코어 속도를 올려도 메모리 용량 부족은 해결되지 않습니다.
RTX 4070 Ti를 유지하면서 성능을 개선하는 안전한 방법
게임과 디자인 작업에 맞춰 드라이버 선택
지포스 앱의 게임 레디(Game Ready) 드라이버와 스튜디오(Studio) 드라이버는 용도별 테스트 기준이 다릅니다.
게임 중심이라면 게임 레디를, 그래픽·영상 제작 프로그램의 안정성이 우선이라면 스튜디오 드라이버를 고려할 수 있습니다. 드라이버를 바꿨다고 무조건 프레임이 크게 늘어나는 것은 아닙니다.
구체적인 설치 화면은 엔비디아 앱 설정과 스튜디오 드라이버 선택 방법과 그래픽카드 드라이버 설치·업데이트 방법을 참고할 수 있습니다.
온도·전력·메모리 사용량을 먼저 확인
- 게임 도중 갑자기 프레임이 떨어진다면 그래픽카드 온도, GPU 사용률, 메모리 점유량을 함께 확인합니다.
- 팬에 먼지가 쌓였는지 살펴보고 케이스 통풍 상태를 점검합니다. 무조건 팬 속도를 최대로 높이거나 전력 제한을 해제할 필요는 없습니다.
- 게임이나 3D 프로그램에서 설정을 낮춰도 성능이 그대로라면 CPU 병목이나 게임 엔진의 제약을 의심할 수 있습니다.
- 로컬 인공지능은 모델 크기와 양자화 방식에 따라 필요한 VRAM이 달라집니다. 12GB를 넘어서는 모델은 단순 연산 속도 향상으로 해결되지 않습니다.
게임 도중 화면이 검게 변하거나 드라이버 오류가 반복되면 그래픽카드 화면 꺼짐·게임 튕김 원인 점검부터 해보는 편이 좋습니다.
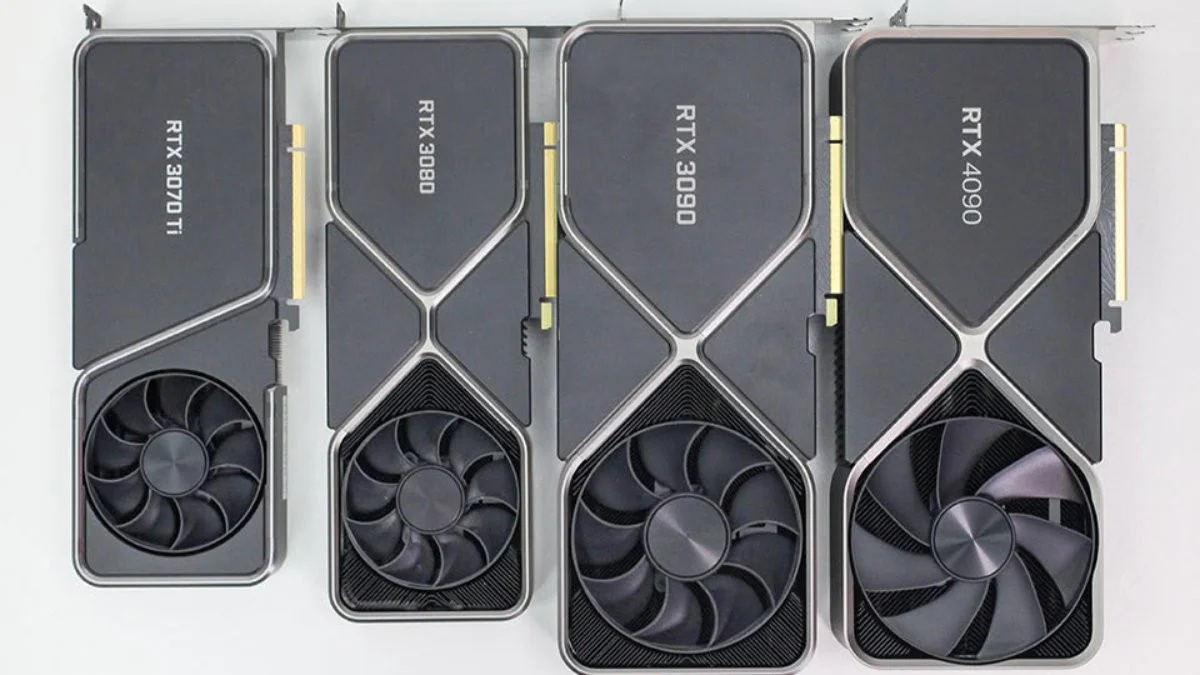
기존 지포스 카드의 연산 성능을 다시 활용하려는 실험은 흥미롭지만 안정성 검증이 중요합니다.
RTX 5070·5080으로 교체할 필요가 있을까?
솔직히 제 RTX 4070 Ti는 아직 버리기 아까운 그래픽카드입니다.
저도 이번에 결혼할 때 컴퓨존에서 새로 맞췄던 컴퓨터이기도 하고, 당시에는 나름 큰돈을 들여 구매했습니다. 요즘은 그래픽카드뿐 아니라 램 가격도 부담돼 5070이나 5080으로 바꾸는 일이 쉽게 결정되지 않네요.
그렇다고 이번 텐서 언락이 4070 Ti를 최신 그래픽카드로 바꿔 주는 마법은 아닙니다. 게임 프레임이 부족한지, 3D 렌더링 시간이 긴지, 아니면 인공지능 모델을 실행할 때 12GB 메모리가 모자라는지에 따라 필요한 업그레이드가 달라집니다.
| 지금 불편한 점 | 먼저 할 일 | 교체 판단 |
|---|---|---|
| 게임 프레임이 낮음 | 해상도·그래픽 옵션·CPU/GPU 사용률 점검 | 게임별 실측 비교 후 결정 |
| 영상 편집에서 끊김 | 원본 코덱·프록시·메모리 사용량 확인 | GPU보다 RAM·스토리지가 병목일 수 있음 |
| AI 모델이 VRAM 부족으로 중단 | 모델 크기·양자화·오프로딩 검토 | 더 큰 VRAM의 가치가 커질 수 있음 |
| 일부 FP32 누적 텐서 계산이 느림 | 연산 경로와 실제 벤치마크 확인 | 실험용 언락은 안정화되기 전까지 관찰 |
그래픽카드 이름에 붙는 Ti와 SUPER의 차이가 헷갈린다면 엔비디아 그래픽카드 등급과 모델 이름 이해하기를 읽어보면 비교에 도움이 됩니다.
RTX 그래픽카드 언락 관련 자주 묻는 질문
RTX 4070 Ti 일반 모델도 텐서 코어 성능을 두 배로 올릴 수 있나요?
RTX 4070 Ti(AD104)를 이용한 한정된 리눅스 실험에서 특정 텐서 명령 속도가 약 두 배로 측정됐습니다. 다만 모든 RTX 4070 Ti와 윈도우 PC에서 같은 결과를 보장하지 않으며, 실제 게임 성능이 두 배 증가하는 것도 아닙니다.
RTX 4070 Ti와 RTX 4070 Ti SUPER는 같은 방법을 쓰나요?
아닙니다. 4070 Ti는 일반적으로 AD104·12GB, 4070 Ti SUPER는 AD103·16GB입니다. 프로젝트에서도 PCI 장치 ID와 모델별 플래그를 구분합니다. 이름이 비슷하다고 서로의 설정을 적용해서는 안 됩니다.
윈도우11용 원클릭 설치 파일은 어디에서 받나요?
2026년 10월 현재 일반 소비자용으로 검증된 공식 원클릭 실행 파일은 확인되지 않습니다. 연구용 윈도우 UEFI 시험 기록은 있지만 특정 메인보드 구성에 의존합니다. 출처를 알 수 없는 실행 파일이나 펌웨어는 설치하지 않는 것이 좋습니다.
언락 프로그램을 쓰면 그래픽카드 보증이 사라지나요?
정상적인 사용 조건을 벗어난 펌웨어·드라이버 변경으로 문제가 생기면 제조사 보증이 제한될 수 있습니다. 실제 적용은 카드 제조사와 보증 약관에 따라 다르므로 임의로 보증 유지 여부를 단정할 수 없습니다.
그래픽카드 전력 소모도 두 배가 되나요?
그런 결과는 아닙니다. 일부 실험은 같은 전력 제한에서 진행됐지만 작업량 증가에 따라 실제 순간 소비전력과 온도는 바뀔 수 있습니다. “전력이 늘지 않는다”는 말도 모든 환경에서 보장되는 사실은 아닙니다.
게임 FPS나 DLSS 성능도 두 배 올라가나요?
이번에 공개된 수치는 주로 FP16·BF16 입력을 FP32로 누적하는 텐서 연산의 속도입니다. 게임 셰이더, 래스터라이징, 광선 추적이나 DLSS 전체 성능이 두 배라는 근거는 없습니다.
RTX 30 시리즈에도 적용 가능한가요?
RTX 30 시리즈의 암페어 GPU를 위한 별도 공개 리눅스 프로젝트가 있습니다. 다만 GPU 칩과 보드별 지원·검증 범위를 반드시 확인해야 하며 RTX 40 시리즈의 설정을 그대로 복사하면 안 됩니다.
RTX 50 시리즈 5070·5080에도 쓸 수 있나요?
이번에 다룬 공개 프로젝트의 검증 대상은 주로 RTX 20·30·40 세대입니다. RTX 50 시리즈가 동일한 방법으로 지원된다는 자료는 확인되지 않았습니다.
공식 사양과 프로젝트 실험 자료 확인
그래픽카드 사양은 엔비디아 RTX 4070 제품군 공식 사양을, 실제 언락 조건은 gpu-unlock-ada 개발 프로젝트와 RTX 4070 Ti 실험 기록을 기준으로 살펴보는 것이 좋습니다. 수치는 발표된 연구 장비의 측정값이며, 다른 컴퓨터에서도 동일하게 재현된다는 의미는 아닙니다.
개인적으로는 새로운 그래픽카드로 교체하기 어려운 시기에 이런 연구가 나온 것 자체가 반갑습니다. 다만 2년 가까이 문제 없이 사용해 온 RTX 4070 Ti를 실험용 펌웨어 하나 때문에 위험에 빠뜨리고 싶지는 않습니다. 일반 사용자라면 검증이 더 쌓일 때까지 지켜보고, 지금 당장은 현재 작업 환경의 병목을 먼저 점검하는 편이 현실적입니다.
'IT 오류해결 > 윈도우·부팅 오류' 카테고리의 다른 글
| 오래된 게임 DLSS 강제 적용 방법 – RTX 리믹스 설치·옵티스케일러·RTX 4070 Ti (0) | 2026.10.28 |
|---|---|
| 포토크래프트 PSD 열기·저장 테스트|폰트 깨짐·레이어·색상 차이 확인 (0) | 2026.10.28 |
| BOOTMGR IS MISSING 해결방법 – 윈도우11·10 부팅오류 MBR·UEFI 복구 (0) | 2026.10.28 |


댓글