고정 헤더 영역

상세 컨텐츠
본문
728x90
반응형
최근 그래픽카드 성능을 이야기할 때 레이 트레이싱, FSR, DLSS, Frame Generation 같은 기술을 빼놓기 어렵습니다.
그런데 AMD가 이번에 공개한 기술은 단순히 해상도를 낮춰 FPS를 높이거나 AI로 프레임을 만들어내는 방식과 조금 다릅니다.
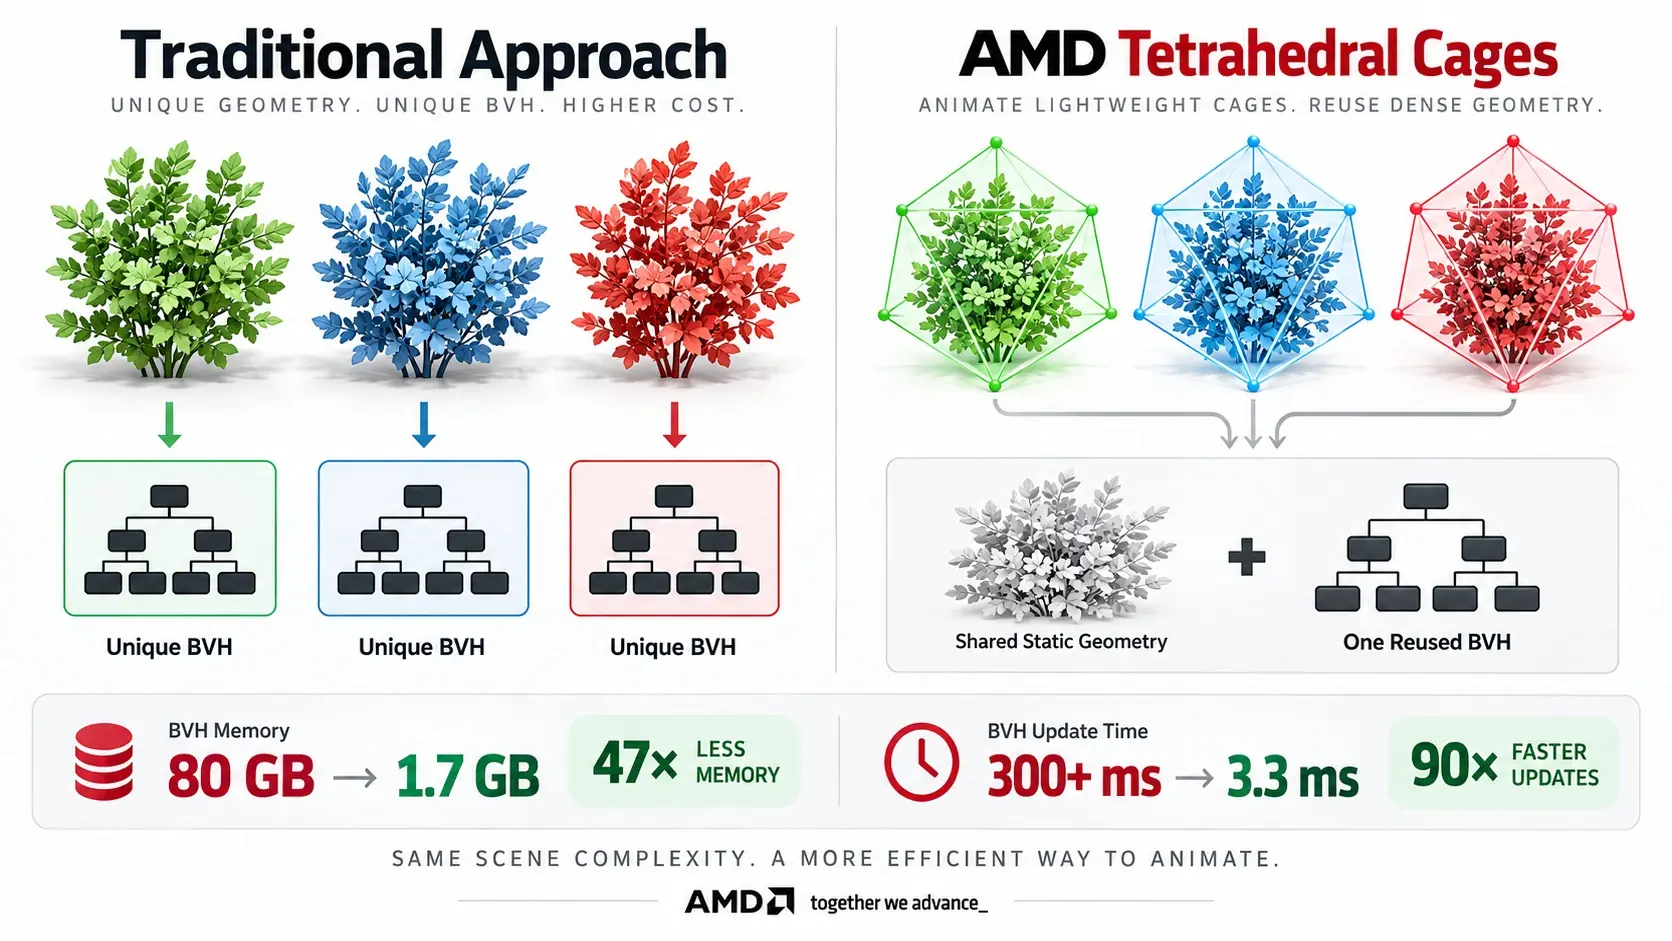
AMD가 공개한 Tetrahedral Cage, 즉 사면체 케이지 기술은 복잡하게 움직이는 3D 지오메트리를 레이 트레이싱할 때 발생하는 BVH 메모리와 업데이트 비용 자체를 줄이는 방식입니다.
실제 데모에서는 Radeon RX 9070 XT를 사용해 약 25,000개의 식물이 각각 독립적으로 움직이는 장면을 처리했습니다.
최대 LOD 상태에서는 약 28억 개의 삼각형에 해당하며, LOD 선택 이후에는 프레임마다 약 5억 개의 애니메이션 삼각형에 Primary Ray와 Shadow Ray를 적용하면서 1080p에서 60FPS 이상으로 동작합니다.
레이 트레이싱 자체의 개념이나 래스터라이징, 글로벌 일루미네이션 차이가 헷갈린다면
먼저 아래 잡가이버 글을 참고하면 이번 AMD 기술을 이해하기 훨씬 쉽습니다.
레이 트레이싱이란? 실제와 같은 빛 반사 그래픽 설정 - GI 차이점
AMD RX 9070 XT에서 정말 5억 개 삼각형을 60FPS로 처리했을까?
먼저 제목에서 가장 오해하기 쉬운 부분부터 정확히 짚어보겠습니다.
RX 9070 XT가 모든 게임에서 5억 개 삼각형을 60FPS로 처리한다는 의미는 아닙니다.
AMD가 만든 특정 연구용 데모에서 대규모 애니메이션 지오메트리와 레이 트레이싱 가속 구조를 효율적으로 처리했을 때 나온 결과입니다.
| 테스트 항목 | AMD GPUOpen 데모 |
|---|---|
| 그래픽카드 | AMD Radeon RX 9070 XT |
| 해상도 | 1920×1080 FHD |
| 식물 수 | 약 25,000개 |
| 최대 LOD 삼각형 | 약 28억 개 |
| LOD 적용 후 | 약 5억 개 / Frame |
| 레이 | Primary Ray + Shadow Ray |
| 성능 | 60FPS 이상 |
AMD가 앞서 공개한 논문 장면에서는 약 5억8,500만 개의 애니메이션 삼각형을 RX 9070 XT에서 1080p 60FPS로 처리한 사례도 소개됐습니다.
이후 공개된 25,000개 식물 데모에서는 LOD 선택 후 약 5억 개 수준으로 설명하고 있기 때문에 두 숫자는 서로 모순이라기보다는 서로 다른 장면과 데모 조건으로 보는 것이 정확합니다.
AMD 공식 RX 9070 XT 사면체 케이지 데모 이미지
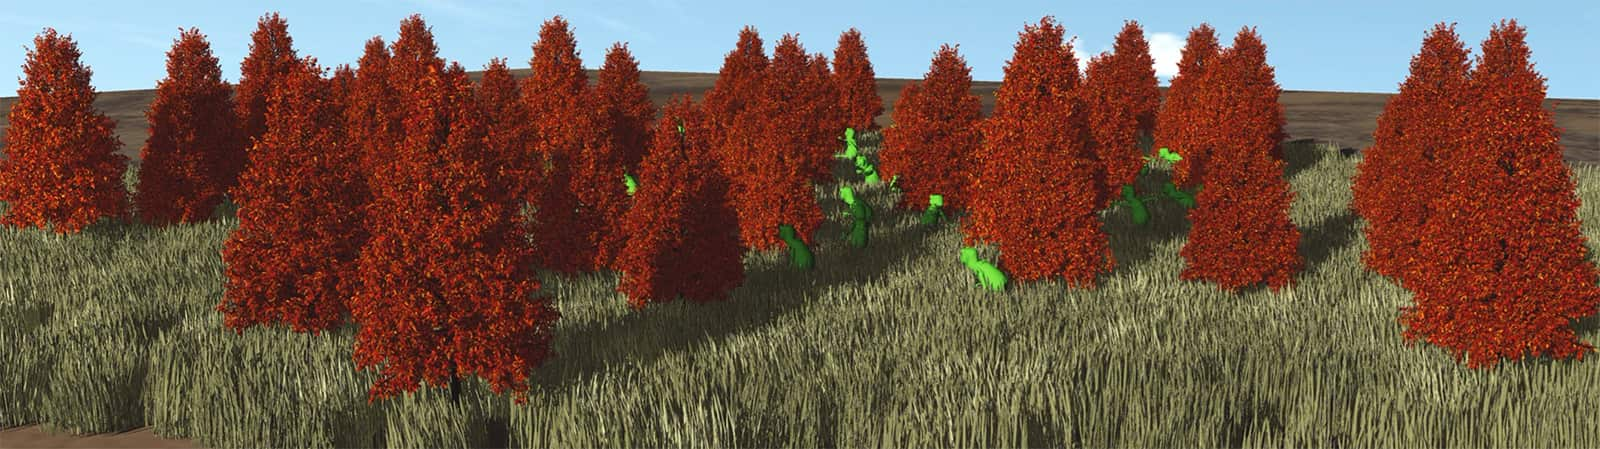
여기서 중요한 것은 화면에 삼각형이 많다는 사실보다 움직이는 각각의 오브젝트에 필요한 가속 구조를 어떻게 관리했느냐입니다.
레이 트레이싱에서 BVH가 중요한 이유
레이 트레이싱에서는 화면에 존재하는 모든 삼각형을 레이 하나마다 무작정 검사하지 않습니다.
그렇게 처리하면 삼각형 개수가 수백만 개만 되어도 연산량이 급격하게 늘어납니다.
그래서 사용하는 것이 BVH(Bounding Volume Hierarchy)입니다.
쉽게 설명하면 수많은 물체를 여러 개의 상자에 나눠 넣고 필요한 상자부터 검색하는 구조라고 보면 됩니다.
예를 들어 숲을 레이 트레이싱한다면?
나무가 25,000그루 있다고 가정해 보겠습니다.
레이 하나가 이동할 때마다 25,000그루의 모든 나뭇잎을 확인한다면 상당히 비효율적입니다.
BVH는 먼저 어느 영역에 있는 나무인지 → 어느 가지인지 → 어느 삼각형인지 순서로 검색 범위를 좁혀줍니다.
BVH·BLAS·TLAS 차이
| 용어 | 역할 | 쉽게 이해하면 |
|---|---|---|
| BVH | 레이 교차검사를 빠르게 만드는 계층 구조 | 공간 검색 지도 |
| BLAS | 개별 메시 내부의 지오메트리 관리 | 나무 한 그루 |
| TLAS | 여러 BLAS 및 오브젝트 배치 관리 | 숲 전체 |
고정된 건물이나 자동차처럼 형태가 변하지 않는 물체라면 한번 만든 BVH를 비교적 효율적으로 재사용할 수 있습니다.
문제는 물체 자체의 형태가 계속 변할 때입니다.
왜 움직이는 풀과 나무가 레이 트레이싱에 부담이 될까?
바람이 불면 나무의 줄기와 가지, 나뭇잎, 풀잎이 계속 움직입니다.
캐릭터 역시 팔과 다리, 옷, 머리카락 등이 매 프레임 변형됩니다.
기존 방식에서는 이런 변형에 맞춰 정점과 레이 트레이싱 가속 구조를 계속 업데이트해야 합니다.
삼각형 수가 많아질수록 GPU 연산량뿐만 아니라 VRAM 사용량과 BVH 업데이트 시간도 함께 늘어납니다.
Tetrahedral Cage 사면체 케이지란?
AMD의 방식은 복잡한 메시 전체를 직접 움직이는 대신 그 주변에 단순한 사면체 형태의 Cage를 만듭니다.
그리고 실제 고밀도 지오메트리를 직접 변경하지 않고 가벼운 Cage만 애니메이션합니다.
레이가 변형된 Cage 내부로 들어오면 레이 자체를 원본 메시가 존재하는 Rest Pose 좌표계로 변환합니다.
덕분에 원본 고밀도 메시와 mini-BLAS는 정적인 상태로 보존하고 여러 애니메이션 오브젝트가 이를 재사용할 수 있습니다.
AMD 공식 사면체 케이지 처리 과정

AMD가 설명한 전체 흐름을 간단하게 정리하면 다음과 같습니다.
- 원본 오브젝트 영역을 Voxel로 분할
- 비어 있는 Voxel 제거
- 나머지 영역을 Tetrahedron으로 분할
- 원본 Mesh를 작은 Mini-Mesh로 분할
- Mini-Mesh 기반 Static Mini-BLAS 생성
- 매 프레임 Tetrahedral Cage만 애니메이션
- Per-Tetrahedron Transform 계산
- Mini-BLAS를 재사용하면서 TLAS 업데이트
- Ray Tracing 수행
핵심은 결국 “Dense Geometry를 매번 다시 움직이지 않는다”는 것입니다.
BVH 메모리 80GB → 1.7GB가 핵심인 이유
이번 AMD 연구에서 60FPS보다 개인적으로 더 눈에 띄는 부분은 BVH 메모리 사용량입니다.
| 비교 | 기존 Dense Triangle BLAS | Tetrahedral Cage |
|---|---|---|
| BVH 메모리 | 최대 약 80GB | 약 1.7GB |
| 프레임당 BVH 업데이트 | 300ms 이상 | 약 3.3ms |
| 애니메이션 삼각형 | 약 5억 개 | 약 5억 개 |
AMD GPUOpen RX 9070 XT 25,000개 식물 데모 수치를 기반으로 잡가이버에서 재구성
수치만 계산하면 BVH 메모리는 약 47배 감소하고 업데이트 시간은 90배 이상 감소합니다.
특히 일반 소비자용 그래픽카드는 VRAM이 제한되어 있기 때문에 80GB에 달하는 BVH를 유지한다는 것은 현실적으로 어렵습니다.
따라서 이번 기술은 단순히 “FPS 몇 프레임 증가”보다 기존에는 메모리 때문에 구성하기 어려웠던 장면을 실시간 레이 트레이싱할 가능성을 높였다는 데 의미가 있습니다.
AMD 공식 HPG 2026 발표영상
사면체 케이지가 실제로 어떻게 동작하는지 글만 보고 이해하기 어렵다면 High-Performance Graphics 2026에서 공개된 공식 발표를 보는 것이 가장 빠릅니다.
Ray Tracing Massive Amounts of Animated Geometry
High-Performance Graphics 2026 공식 발표
FSR·AFMF·Frame Generation과는 무엇이 다를까?
RX 9070 XT와 60FPS라는 숫자 때문에 이번 기술을 FSR 4 또는 Frame Generation과 같은 기능으로 생각하기 쉽습니다.
하지만 처리하는 영역 자체가 다릅니다.
| 기술 | 하는 일 |
|---|---|
| FSR Upscaling | 낮은 내부 해상도를 높은 해상도로 복원 |
| FSR Frame Generation | 렌더링 프레임 사이에 추가 프레임 생성 |
| AFMF | AMD 드라이버 단계에서 프레임 생성 |
| Ray Regeneration | 레이 트레이싱 결과의 디테일 복원 |
| Tetrahedral Cage | 애니메이션 지오메트리와 BVH 처리비용 감소 |
라데온에서 실제 게임 FPS를 높이기 위한 AFMF 설정은 아래 글에서 별도로 확인할 수 있습니다.
AMD AFMF 활성화 및 라데온 GPU 최적 Adrenalin 그래픽 설정방법
NVIDIA DLSS와 AMD FSR의 차이를 먼저 알고 싶다면 아래 글도 함께 참고하세요.
NVIDIA DLSS 버전별 차이 및 AMD FSR 비교
즉 FSR과 DLSS는 완성된 화면과 프레임을 효율적으로 만드는 쪽이라면, Tetrahedral Cage는 그보다 앞 단계에서 3D Geometry와 Ray Tracing Acceleration Structure를 처리하는 비용 자체를 줄이는 방식입니다.
Frame Generation으로 만든 60FPS와도 다르다
이번 AMD 데모의 60FPS라는 숫자를 보고 AI 프레임 생성을 이용해 60FPS로 만든 것이 아닌지 궁금할 수 있습니다.
AMD GPUOpen이 설명하는 핵심은 약 5억 개의 움직이는 삼각형에 Primary Ray와 Shadow Ray를 적용하면서 레이 트레이싱 파이프라인 자체의 비용을 줄였다는 것입니다.
따라서 브라우저 영상이나 게임에서 중간 프레임을 만들어내는 Frame Interpolation과는 원리가 다릅니다.
프레임 생성 자체가 어떻게 작동하는지 궁금하다면 아래 실사용 글도 같이 보면 이해하기 좋습니다.
Framegen 프레임 보간 사용법 - 유튜브 영상 60FPS·120FPS 만들기
어떤 게임에서 Tetrahedral Cage 효과가 클까?
모든 게임과 모든 3D 모델에서 같은 효과를 얻을 수 있는 기술은 아닙니다.
AMD가 제시하는 활용 분야를 보면 같은 형태의 고밀도 모델이 매우 많이 존재하면서 각각 다른 변형을 가지는 장면에 특히 적합합니다.
- 오픈월드 게임의 숲과 나무
- 바람에 흔들리는 수십만 개의 잔디
- 대규모 NPC 군중
- 원거리 캐릭터
- 생물·동물 군집
- 바람이나 충돌에 반응하는 식물
- 게임용 Animation LOD
- 대규모 실시간 시뮬레이션
숲이 많은 오픈월드 게임이라면?
예를 들어 넓은 숲에서 나무가 25,000개 존재한다고 가정해 보겠습니다.
모든 나무가 같은 방향으로 똑같이 흔들리는 것이 아니라 지역별 바람 방향에 따라 각기 다르게 움직이면 각 오브젝트의 지오메트리 상태가 계속 달라집니다.
이런 장면은 기존 방식에서 BLAS 업데이트와 VRAM 사용량이 큰 병목이 될 수 있습니다.
Tetrahedral Cage 방식은 이런 경우 복잡한 나무 메시 대신 Cage를 움직이기 때문에 효과를 볼 가능성이 높습니다.
Unreal Engine 게임에도 바로 적용할 수 있을까?
여기서도 오해하면 안 되는 부분이 있습니다.
AMD Adrenalin에서 옵션 하나를 켜면 사용할 수 있는 기능은 아닙니다.
FSR 또는 AFMF처럼 사용자가 직접 활성화하는 그래픽 옵션도 아닙니다.
현재는 게임엔진 또는 렌더링 엔진 개발자가 파이프라인에 직접 구현해야 하는 기술에 가깝습니다.
AMD는 DXR 샘플과 함께 Skinned Object, Keyframe Animated Object, Static Object용 고품질 Tetrahedral Cage 생성을 지원할 header-only C++ 라이브러리 개발을 진행하고 있다고 밝혔습니다.
DirectX Raytracing DXR과 함께 사용할 수 있다
이 기술은 Microsoft DirectX Raytracing과 별개의 API를 새로 만드는 것이 아니라 기존 DXR 파이프라인과 조합할 수 있는 최적화 기법입니다.
AMD는 DXR Functional Spec Part 2의 Partitioned Top-Level Acceleration Structure와 함께 사용할 수 있으며 Cluster-Level Acceleration Structure와도 공존할 수 있다고 설명합니다.
사면체 케이지의 단점도 있다
성능만 보면 상당히 좋아 보이지만 모든 지오메트리를 이 방식으로 대체할 수 있는 것은 아닙니다.
1. 정점을 완벽하게 제어하기 어렵다
Tetrahedral Cage는 실제 Mesh 정점을 하나씩 움직이는 대신 Cage를 이용해 변형을 근사합니다.
따라서 아주 정밀한 움직임이 필요한 캐릭터에서는 원본 Animation과 차이가 발생할 수 있습니다.
2. Cage가 단순할수록 오차가 커진다
사면체 수를 줄이면 메모리와 연산량은 줄어들지만 애니메이션 정확도 역시 떨어질 수 있습니다.
반대로 Cage를 지나치게 촘촘하게 만들면 정확도는 증가하지만 성능 절감 효과가 줄어듭니다.
3. Topology가 변하는 애니메이션에는 불리하다
특히 다음과 같이 Mesh 연결 구조 자체가 크게 달라지는 경우에는 적합하지 않을 수 있습니다.
- 물체가 부서지면서 분리되는 장면
- 절단되는 캐릭터나 물체
- Topology 자체가 변하는 Mesh
- 아주 세밀한 얼굴 근육 표현
- 근접 촬영되는 날카로운 변형
게임에서 VRAM 부족 오류가 발생한다면?
이번 기술이 주목받는 이유 중 하나가 VRAM이기 때문에 RX 9070 XT와 같은 그래픽카드에서 실제 게임을 할 때 발생하는 메모리 부족 문제와 연결해서 볼 수도 있습니다.
다만 게임에서 발생하는 Out of Video Memory, GPU Device Removed, Driver Timeout 오류가 Tetrahedral Cage와 직접 관련 있다는 의미는 아닙니다.
일반적인 게임에서는 다음 항목을 먼저 확인합니다.
- Texture Quality
- Ray Tracing Quality
- Resolution
- FSR 또는 DLSS 설정
- Frame Generation
- VRAM 사용량
- 그래픽 드라이버 버전
- GPU 오버클럭·언더볼팅
AMD 드라이버 Timeout·화면 깨짐이 발생한다면?
새로운 그래픽 기술을 테스트할 때는 드라이버 상태가 상당히 중요합니다.
기존 NVIDIA GPU에서 Radeon으로 변경했거나 여러 번 그래픽 드라이버를 덮어 설치했다면 잔여 드라이버가 충돌할 수도 있습니다.
그래픽카드 교체 후 블랙스크린, 화면깨짐, Driver Timeout이 발생한다면 아래 방법을 먼저 확인해보세요.
그래픽카드 교체 후 화면 이상 - DDU 드라이버 잔여물 삭제방법
AMD·NVIDIA·Intel 그래픽 드라이버 설치와 업데이트 방법은 아래 글에서 확인할 수 있습니다.
그래픽카드 드라이버 설치 및 업데이트 방법
게임뿐 아니라 3D 그래픽 작업에도 의미가 있을까?
Tetrahedral Cage가 주목받는 이유를 게임으로만 한정해서 볼 필요는 없습니다.
Blender, 3ds Max, Maya, Unreal Engine, Unity와 같은 3D 환경에서도 대량의 애니메이션 Geometry를 실시간으로 처리해야 하는 경우가 있습니다.
다만 이 기술이 공개됐다고 해서 Blender Cycles나 3ds Max 렌더링 속도가 자동으로 빨라지는 것은 아닙니다.
각 렌더러와 엔진에서 해당 기술을 구현해야 실제 성능 향상을 기대할 수 있습니다.
CAD·제품설계에서는?
Siemens NX, Solid Edge, CATIA, Creo 같은 CAD는 게임의 풀이나 캐릭터처럼 수많은 메시가 매 프레임 휘어지는 상황이 상대적으로 적습니다.
그래서 일반적인 제품 모델링 자체보다는 Digital Twin, 공장 시뮬레이션, 로봇 움직임, 제조 설비 시각화, 대규모 Assembly 실시간 Visualization 같은 분야에서 응용 가능성을 생각해볼 수 있습니다.
RX 9070 XT뿐 아니라 다른 그래픽카드에서도 사용할 수 있을까?
이번 AMD 데모에서 직접 성능 수치를 공개한 GPU는 Radeon RX 9070 XT입니다.
따라서 아래 그래픽카드가 동일한 성능을 낸다고 해석해서는 안 됩니다.
| GPU | 이번 데모 직접 검증 |
|---|---|
| Radeon RX 9070 XT | 공개 테스트 O |
| Radeon RX 9070 | 동일 조건 수치 공개 안 됨 |
| Radeon RX 7900 XTX | 동일 조건 수치 공개 안 됨 |
| Radeon RX 7800 XT | 동일 조건 수치 공개 안 됨 |
| GeForce RTX 5070 Ti | AMD 자료에서 직접 비교 안 됨 |
| GeForce RTX 5080 | AMD 자료에서 직접 비교 안 됨 |
| GeForce RTX 5090 | AMD 자료에서 직접 비교 안 됨 |
즉 이번 연구를 가지고 “RX 9070 XT가 RTX 5080보다 레이 트레이싱이 빠르다”와 같은 그래픽카드 성능 비교를 하는 것은 적절하지 않습니다.
AMD Tetrahedral Cage FAQ
RX 9070 XT에서 설정으로 켤 수 있나요?
아닙니다. 현재 AMD Adrenalin의 그래픽 옵션으로 활성화하는 기능이 아니라 게임엔진과 렌더러 개발자가 구현해야 하는 기술입니다.
FSR 4와 같은 기능인가요?
아닙니다. FSR은 Upscaling, Frame Generation 등 최종 화면 생성과 관련된 기술이며 Tetrahedral Cage는 움직이는 Geometry와 Ray Tracing Acceleration Structure의 비용을 줄이는 기술입니다.
정말 28억 개 삼각형을 매 프레임 렌더링하나요?
25,000개의 식물을 최고 LOD로 계산하면 약 28억 개 삼각형에 해당합니다.
하지만 실제 프레임에서는 LOD를 적용해 약 5억 개의 애니메이션 삼각형을 레이 트레이싱합니다.
왜 80GB가 필요한가요?
25,000개의 고밀도 식물이 각각 독립적으로 변형되면 기존 방식에서는 각 객체의 Geometry 상태에 따라 Dense Triangle BLAS를 유지하고 업데이트해야 합니다.
AMD가 비교한 해당 테스트 장면에서는 기존 방식이 최대 약 80GB의 GPU 메모리를 요구할 수 있다고 설명합니다.
사면체 케이지에서는 왜 1.7GB밖에 필요하지 않나요?
고밀도 원본 Geometry와 BVH를 정적인 상태로 유지하고 재사용하면서 상대적으로 단순한 Cage만 변형하기 때문입니다.
게임 FPS가 90배 증가한다는 의미인가요?
아닙니다. 90배라는 숫자는 전체 게임 FPS가 아니라 해당 데모에서 BVH Update 시간의 차이입니다.
게임 전체 FPS에는 Pixel Shader, CPU Draw Call, Texture Streaming, Lighting, Post Processing 등 다양한 병목이 함께 영향을 줍니다.
이번 AMD 기술에서 진짜 중요한 숫자는 60FPS가 아니다
처음 내용을 접하면 가장 눈에 들어오는 숫자는 “5억 개 삼각형, 60FPS”입니다.
하지만 제가 보기에는 이번 연구에서 더 중요한 수치는
80GB → 1.7GB
300ms+ → 약 3.3ms
라고 생각합니다.
GPU 성능이 아무리 빨라져도 매 프레임 엄청난 양의 Geometry와 BVH를 다시 만들고 메모리에 저장해야 한다면 실시간 레이 트레이싱에는 한계가 있습니다.
Tetrahedral Cage는 GPU를 무작정 더 빠르게 만드는 것이 아니라 애초에 처리해야 하는 데이터와 업데이트 비용을 줄이는 방향으로 접근합니다.
앞으로 Unreal Engine이나 자체 게임엔진에서 대규모 식생, 군중, 생물, 원거리 Character LOD 등에 이 방식이 실제 적용되기 시작한다면 지금보다 훨씬 복잡한 움직임을 가진 장면에서 실시간 레이 트레이싱을 사용하는 데 도움이 될 가능성이 있습니다.
잡가이버 관련 글
이번 글과 함께 보면 이해하기 좋은 잡가이버의 그래픽카드·레이 트레이싱 관련 글입니다.
AMD AFMF 활성화 및 Radeon Adrenalin 최적 설정
NVIDIA DLSS 버전별 차이와 AMD FSR 비교
Frame Generation 원리 - 유튜브 60FPS·120FPS 프레임 보간
그래픽카드 교체 후 화면이상 - DDU 드라이버 완전삭제
AMD·NVIDIA·Intel 그래픽카드 드라이버 설치 및 업데이트
AMD 공식자료
AMD GPUOpen - Ray Tracing Massive Amounts of Animated Geometry Using Tetrahedral Cages
AMD GPUOpen - How Tetrahedral Cages Significantly Reduce BVH Memory Usage
High-Performance Graphics 2026 - Ray Tracing Massive Amounts of Animated Geometry
반응형
그리드형
'제품·구매리뷰 > 게임 리뷰' 카테고리의 다른 글
| PS5X Xbox Series X PS5 에뮬레이터 사용법|KytyPS5 다운로드·지원게임·설정 (0) | 2026.09.21 |
|---|---|
| 애니모 공략 총정리|도감·상성표·천휘·육성 한 번에 (0) | 2026.09.18 |
| 애니모 속성 상성표·개체값 공략|선천·후천 잠재력, 콘텐츠, BM까지 (0) | 2026.09.18 |


